Bonjour à tous,
Après 10 ans sous LibreNMS pour mon monitoring, j’avais envie de changement, la solution était trop bruyante pour mes besoins (en même temps c’est un outil de surveillance réseau à la base).
Après un petit passage sous PRTG, je me suis rendu compte que je ne voulais pas avoir le même outil qu’au boulot, j’ai donc décidé de faire un peu le tour de ce qui existait et j’ai retenu CheckMK pour mon besoin.
J’en profite pour poser un peu de boulot que j’ai fait pour PRTG sur mon Github si cela vous intéresse, spécialement pour gratter des sondes ou afficher le tout sur Grafana : https://github.com/stylersnico?tab=repositories&q=prtg&type=&language=&sort=
Le but de cet article n’est pas de vous expliquer l’installation de CheckMK mais de partager quelques astuces pour la configuration de celui-ci, certaines logiques internes étant retors (on va le voir avec le premier exemple).
La configuration de périodes de temps sans vérifications
Je commence par le truc tordu, en tout cas sur la version gratuite lorsque l’on souhaite configurer des périodes de maintenance / d’extinction des serveurs.
En version payante, vous avez les “scheduled downtimes”, simple, efficace et ça fait ce qui est prévu.
Maintenant sur la version communautaire, il n’y a pas cette fonction, il est donc possible d’utiliser les “checks periods” et vous allez voir, on va rire.
La première chose à faire étant de faire une règle et une période de temps pour indiquer les heures de fonctionnement de votre serveur.
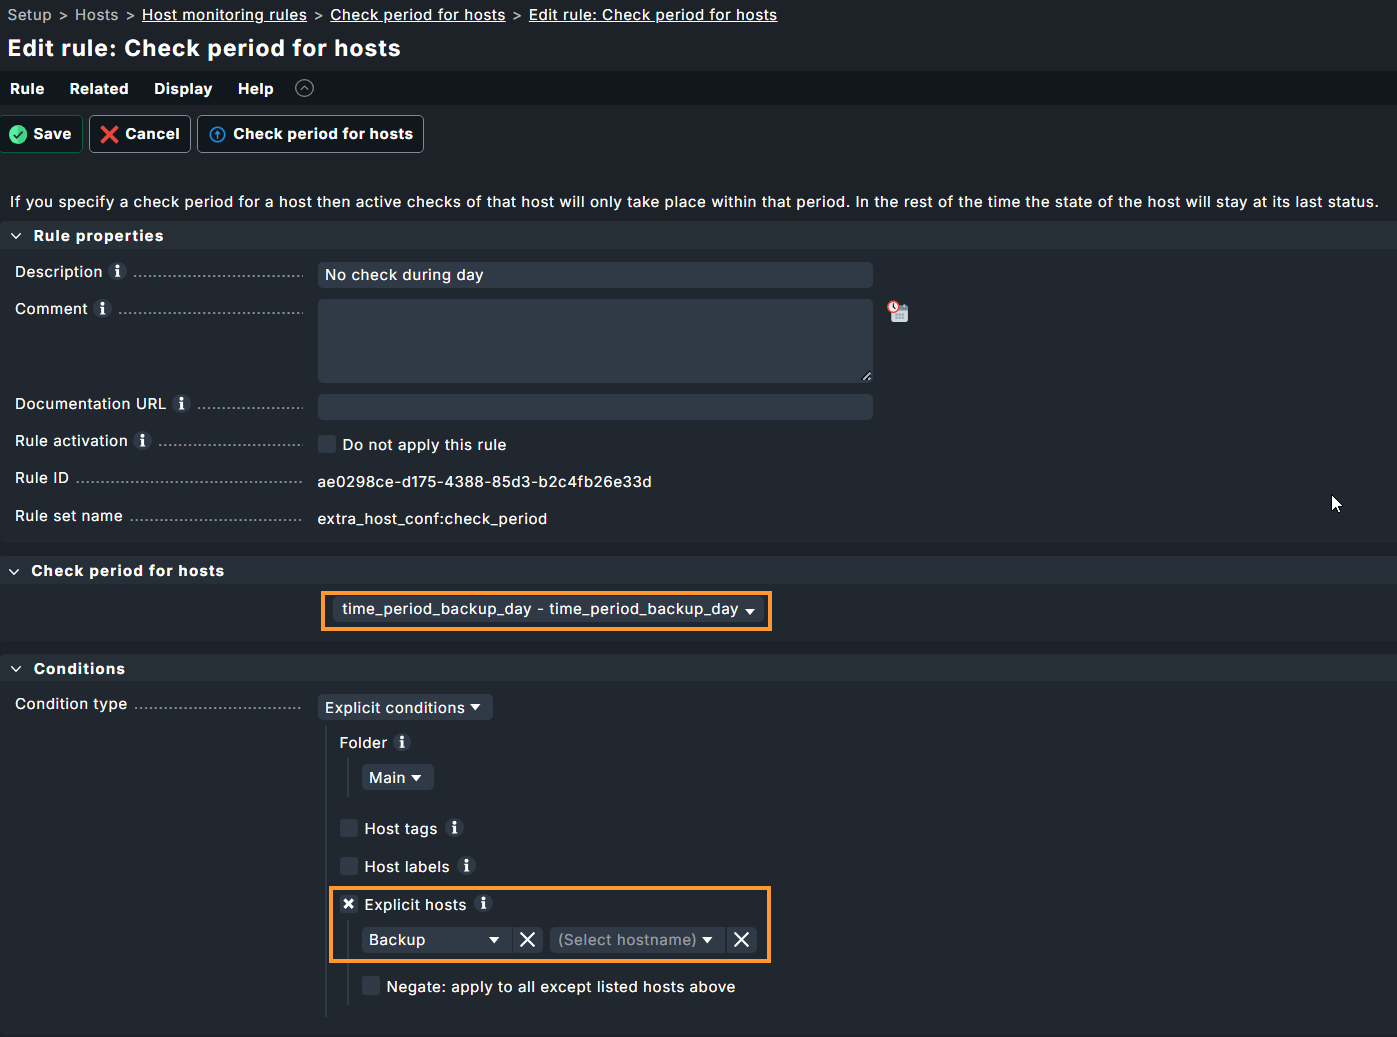
Dans les “host monitoring rules” vous pouvez créer une nouvelle règle de “check period for hosts” en indiquant l’hôte auquel s’applique la règle et la période de temps :
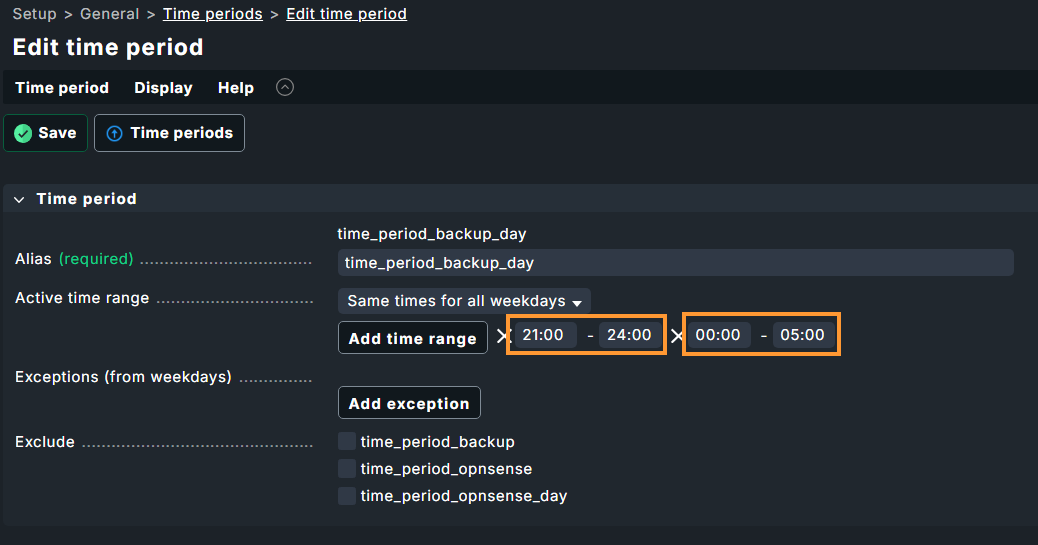
La période temps se configure depuis les “time periods”, vous indiquez les heures de fonctionnement selon le format suivant :
Maintenant on arrive à la partie loufoque de la logique interne de CheckMK.
Avec cette configuration, vous n’aurez plus de notification si l’hôte est éteint en dehors de ces heures, PAR CONTRE, vous aurez toujours des notifications des services qui sont sur l’hôte (qui auront forcément un problème si l’hôte est éteint …).
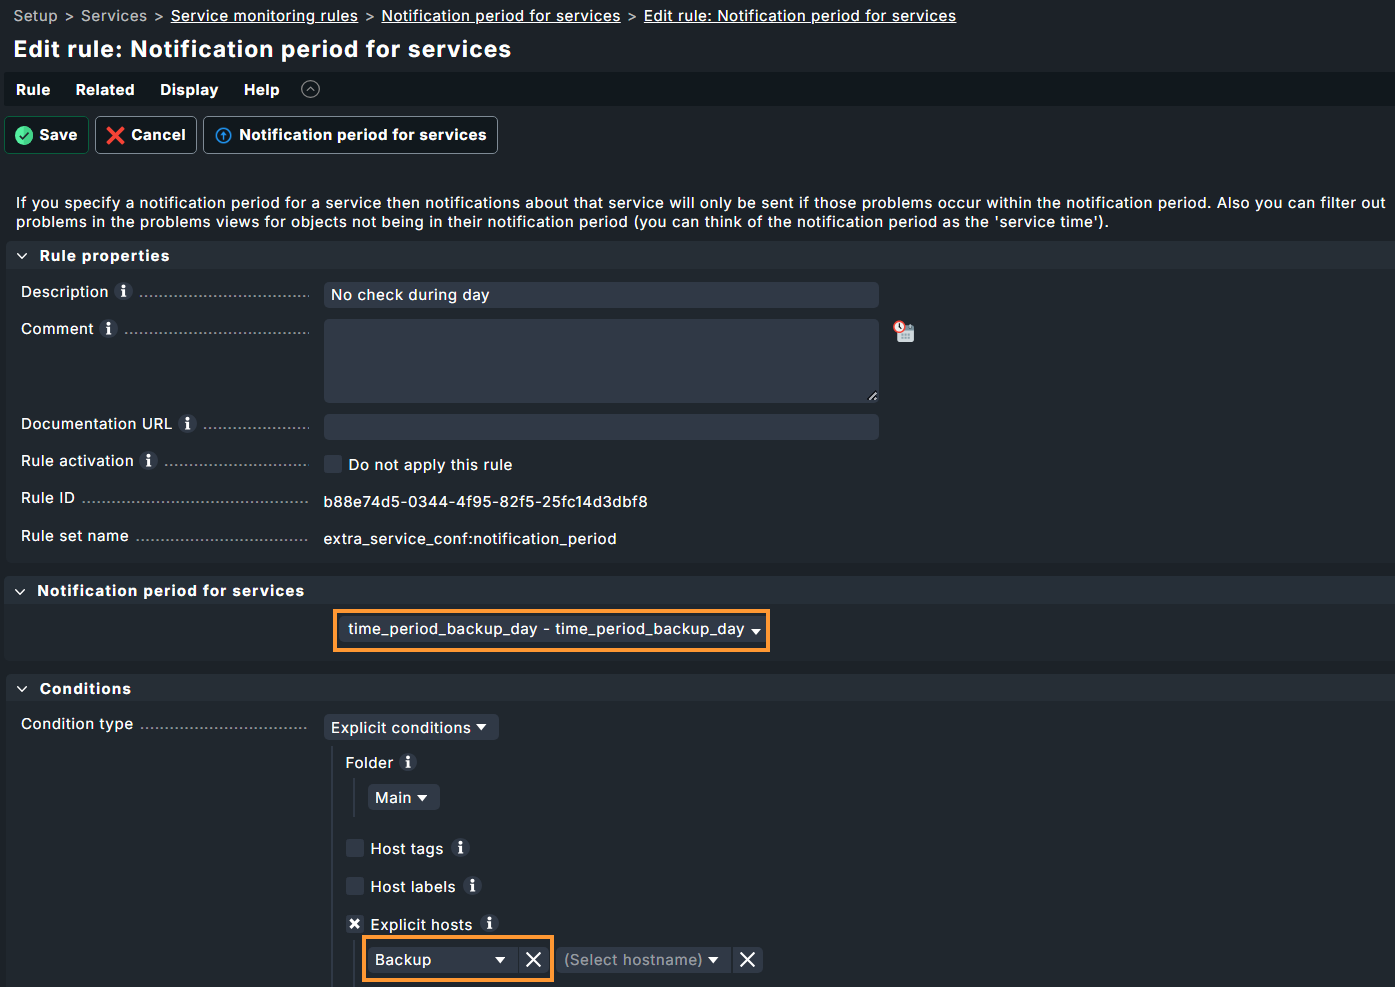
Pour contrer cela, il faut aussi faire une règle dans les “services monitoring rules” et ensuite dans les “notification period for services” avec le même hôte et la même timezone :
La surveillance des services Systemd
En continuant dans les logiques tortueuses de CheckMK, la configuration des services que l’on souhaite surveiller, notamment les services Systemd ou le reste (qu’on va voir après), ne se fait pas par hôte comme sur un PRTG mais par des règles génériques.
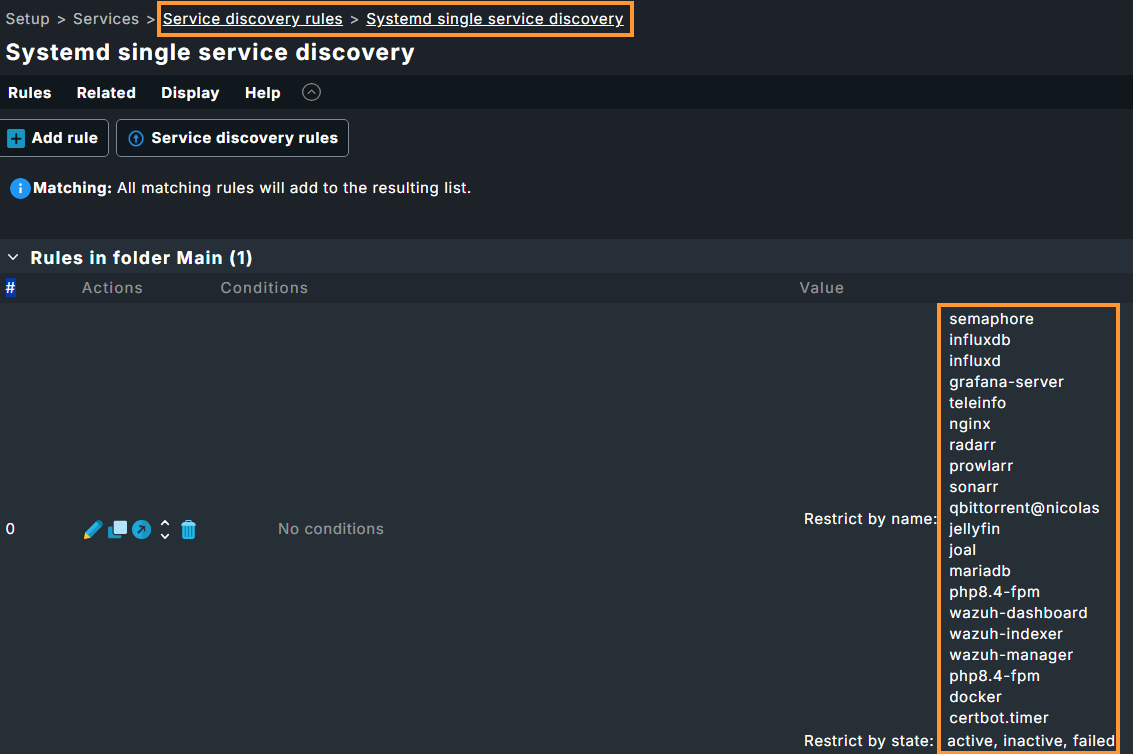
Le plus simple étant de vous faire une règle générique qui liste tous les services possibles et imaginables que vous souhaitez surveiller, ensuite s’ils existent ils s’ajouteront automatiquement à la prochaine découverte de chaque hôte.
Cela se fait dans les “Services Discovery Rules” sous les “Systemd single service discovery” (qui porte mal son nom car on peut en mettre plusieurs) :
Surveillance Docker
Pour cette partie c’est simple, c’est natif et ils fournissent le script à mettre sur votre machine, cela demande juste le paquet python3-docker :
apt install python3-docker -y
cd /usr/lib/check_mk_agent/plugins
wget http://192.168.1.15:8080/cmk/check_mk/agents/plugins/mk_docker.py
chmod 0755 mk_docker.py
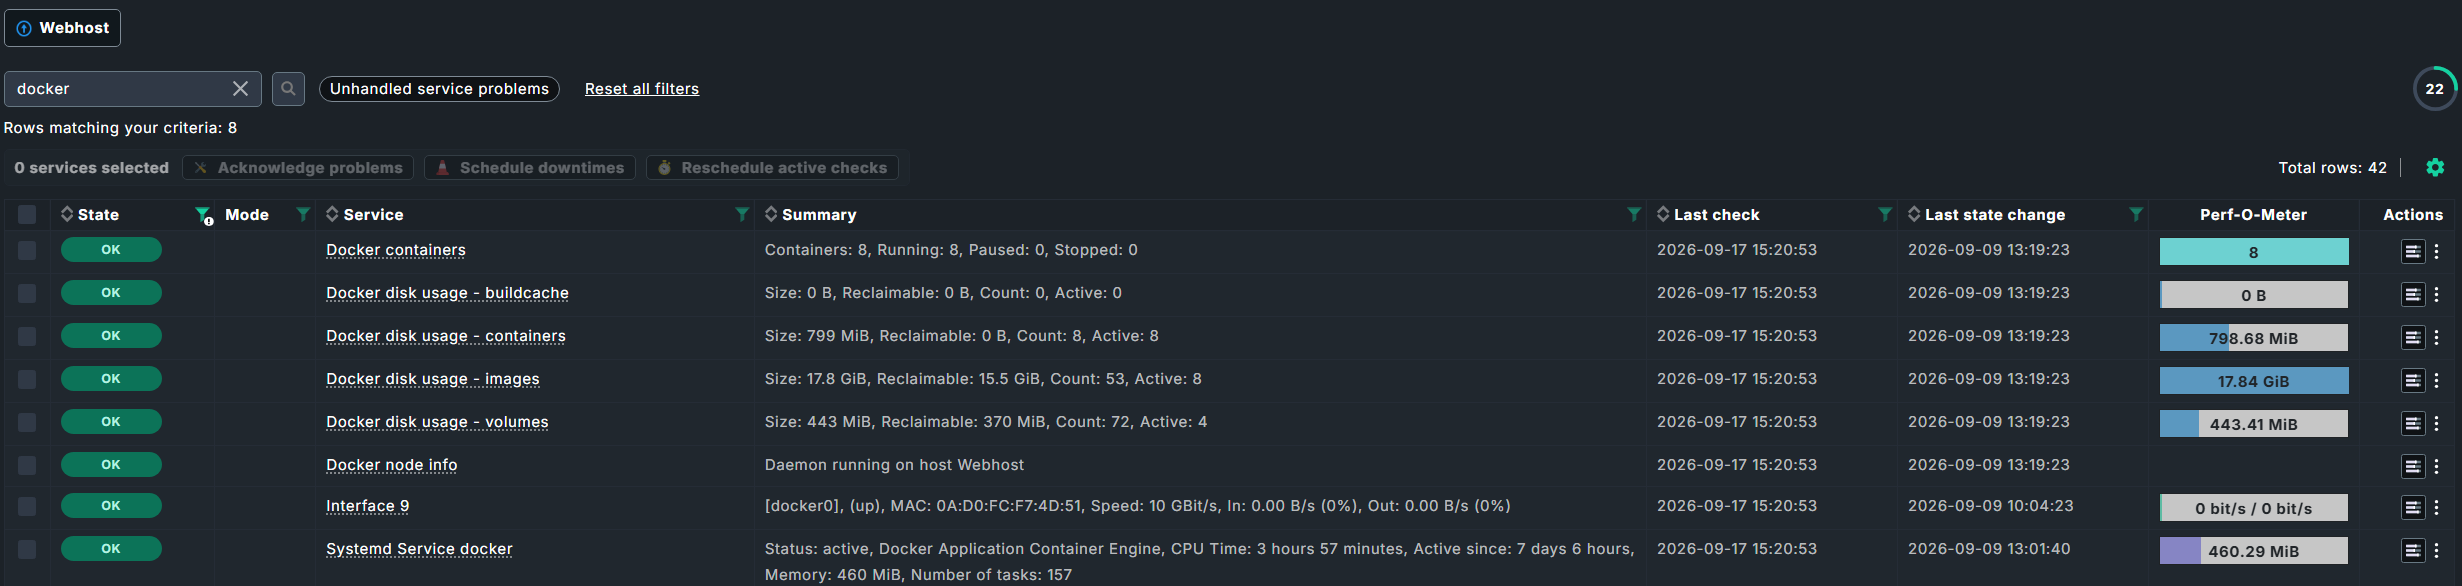
Adaptez simplement en mettant l’url de votre instance CheckMK et à la prochaine découverte, les infos sur vos conteneurs remonteront :
Surveillance S.M.A.R.T. sous Windows
Encore une fois c’est assez simple, mais là, le script est communautaire.
Installez d’abord SmartMonTools et lancez la commande suivante en powershell :
Invoke-WebRequest -Uri "https://raw.githubusercontent.com/andfas/checkmk/refs/heads/master/smart.ps1" -OutFile "$env:PROGRAMDATA\checkmk\agent\plugins\smart.ps1"
Et ensuite, testez le script :
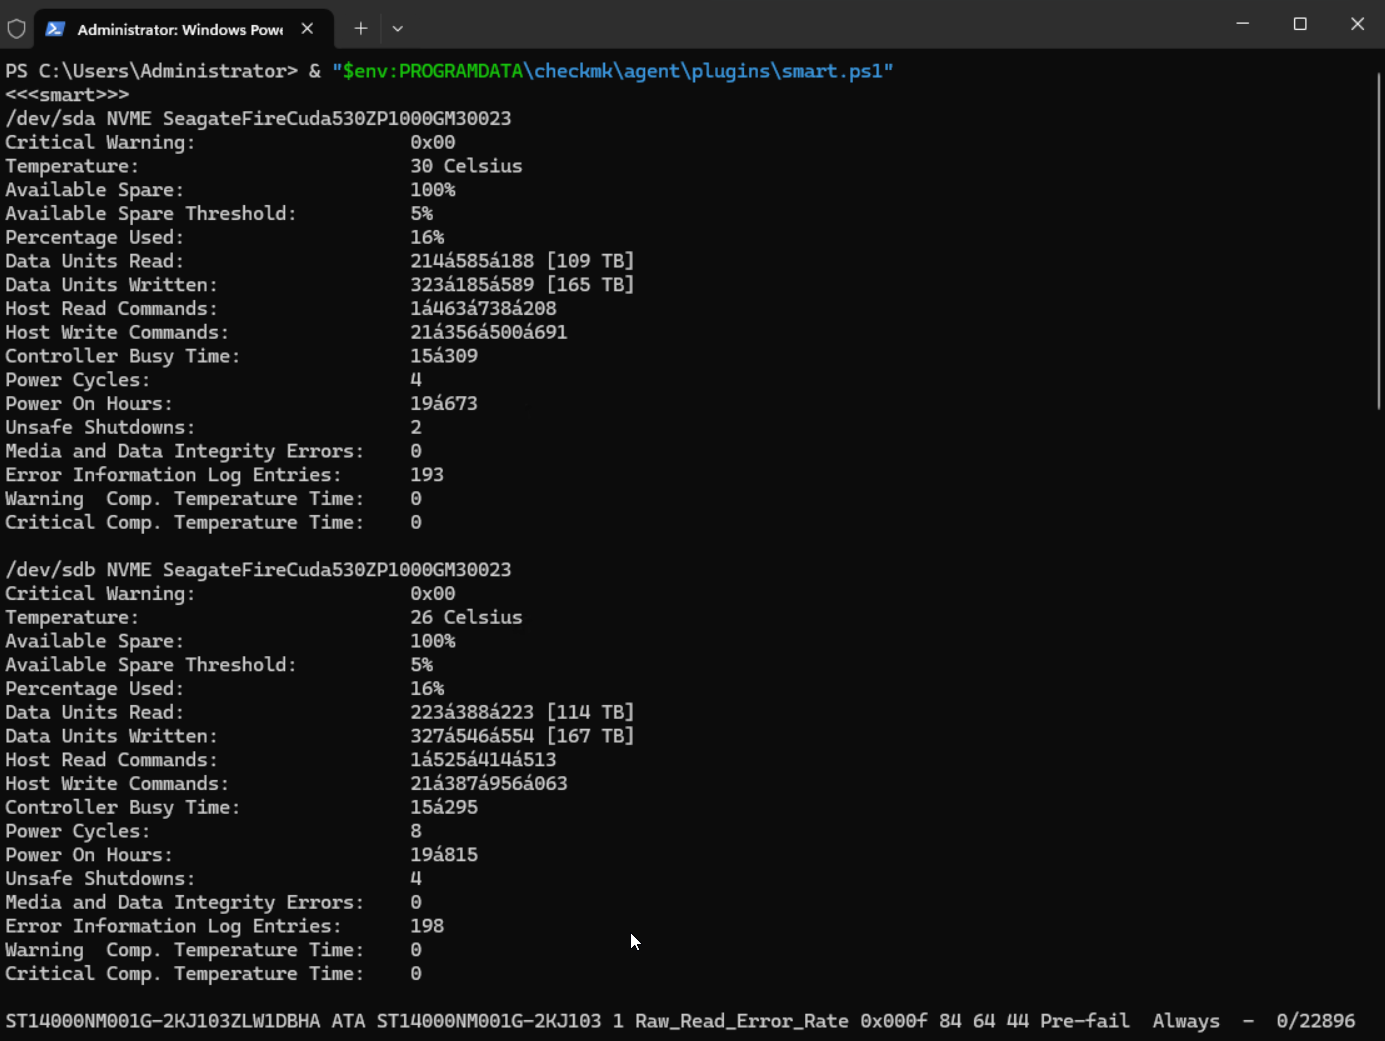
& "$env:PROGRAMDATA\checkmk\agent\plugins\smart.ps1"
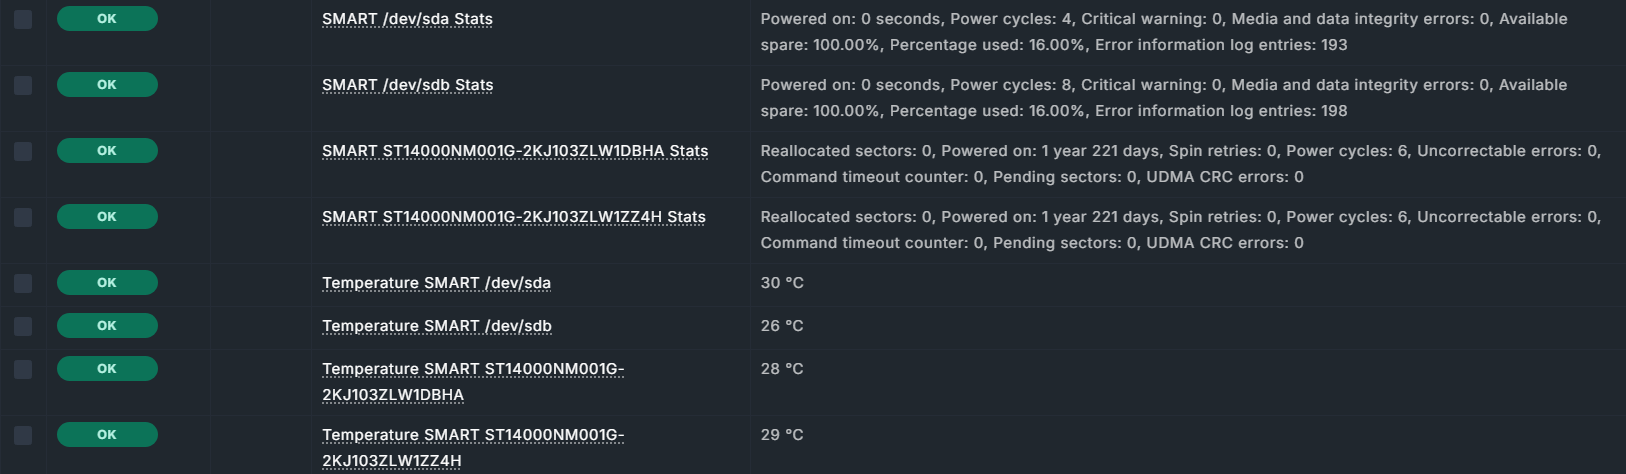
Vous devriez avoir un retour complet comme ceci :
Et ensuite dans l’interface :
Vérification des services Web (DNS, HTTP, SSL …)
Comme avant, les services ne se programment pas depuis l’hôte, mais encore dans un autre menu “Services -> HTTP,TCP, EMAIL > Check HTTP web Service” par exemple.
Dans la même veine, vous faites une grosse liste de ce que vous souhaitez vérifier mais avec une condition par hôte cette fois-ci :
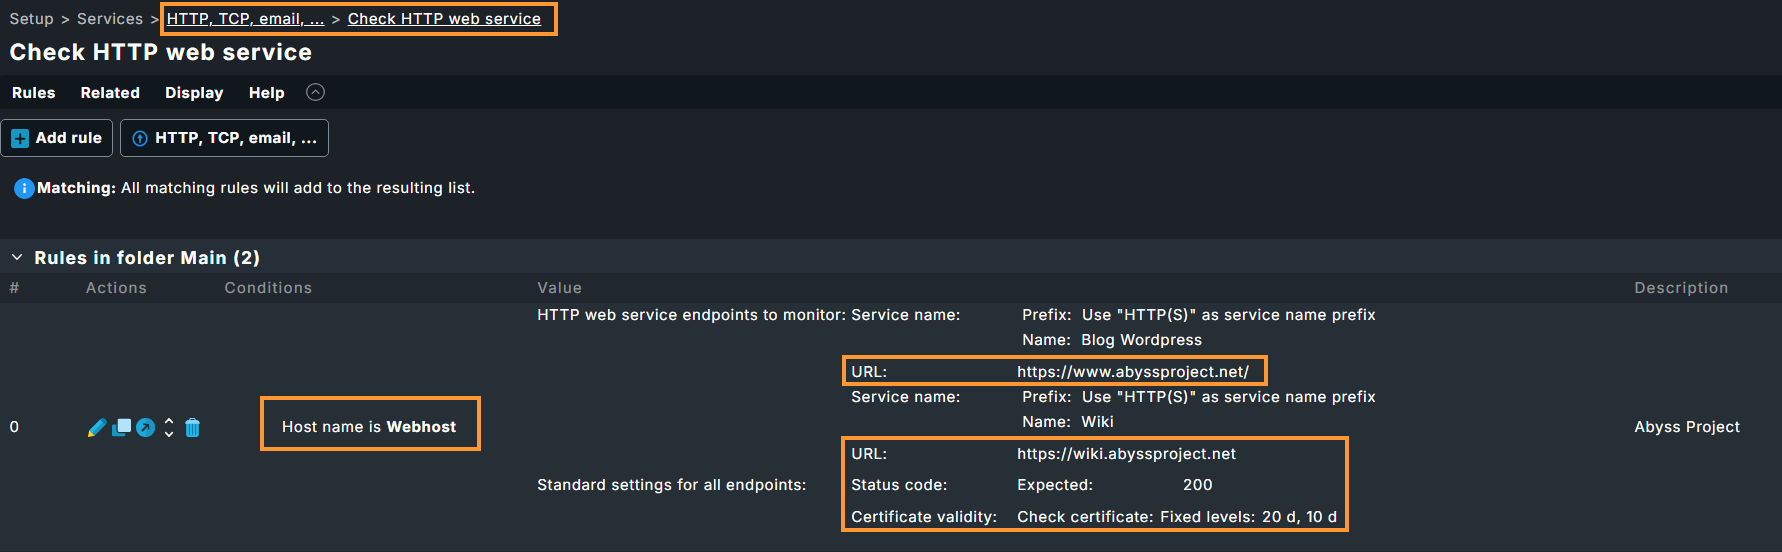
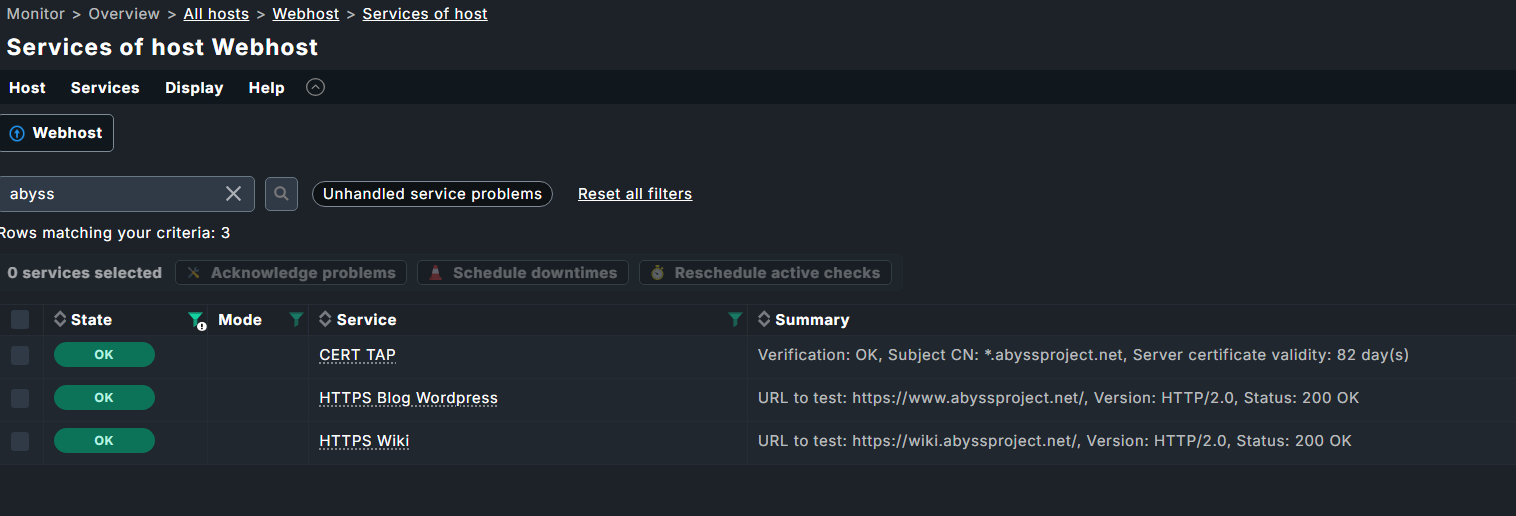
C’est cette condition qui fait que les services seront vérifiés uniquement depuis cet hôte :
Notifications via Telegram
Un très bon article existe, donc je ne vais pas tout réexpliquer : https://checkmk.com/blog/checkmk-notifications-via-telegram
On repart sur la logique à la con du début.
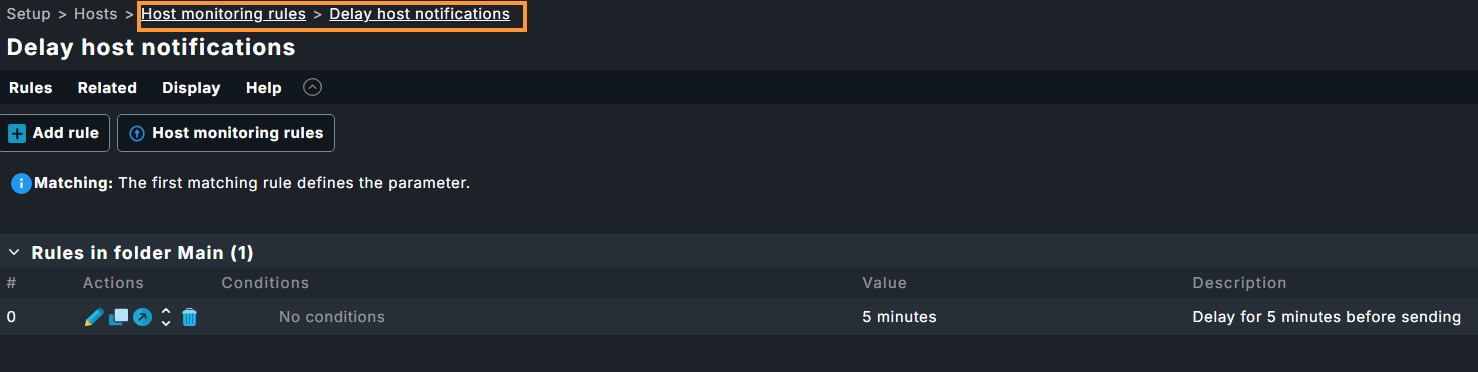
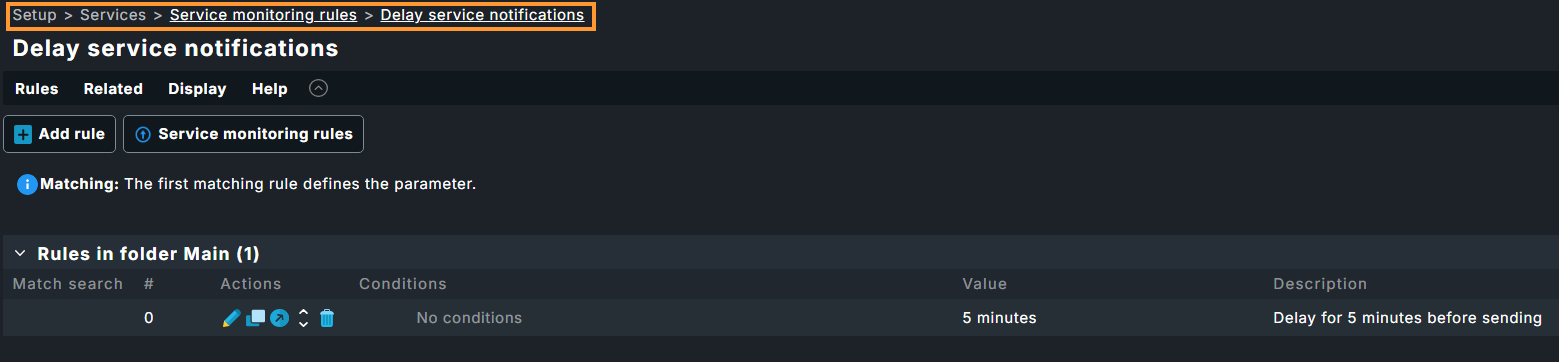
L’idée étant de laisser un petit délai afin de confirmer le problème avant de recevoir une notification, pour mon usage 5 minutes.
Mais, comme pour la vérification des services et des hôtes, ce délai est à configurer… 2 fois (un paramètre directement au niveau des notifications, c’était compliqué manifestement) :
Comme vous l’aurez maintenant compris, dans la logique de Checkmk, absolument tout utilise des règles et rien ne se fait directement depuis les hôtes, hormis pour la mise en place des plugins si besoin.
Je crois que j’ai fait le tour de tout ce qui m’a interrogé ou intéressé lors de la mise en place de la solution 🙂